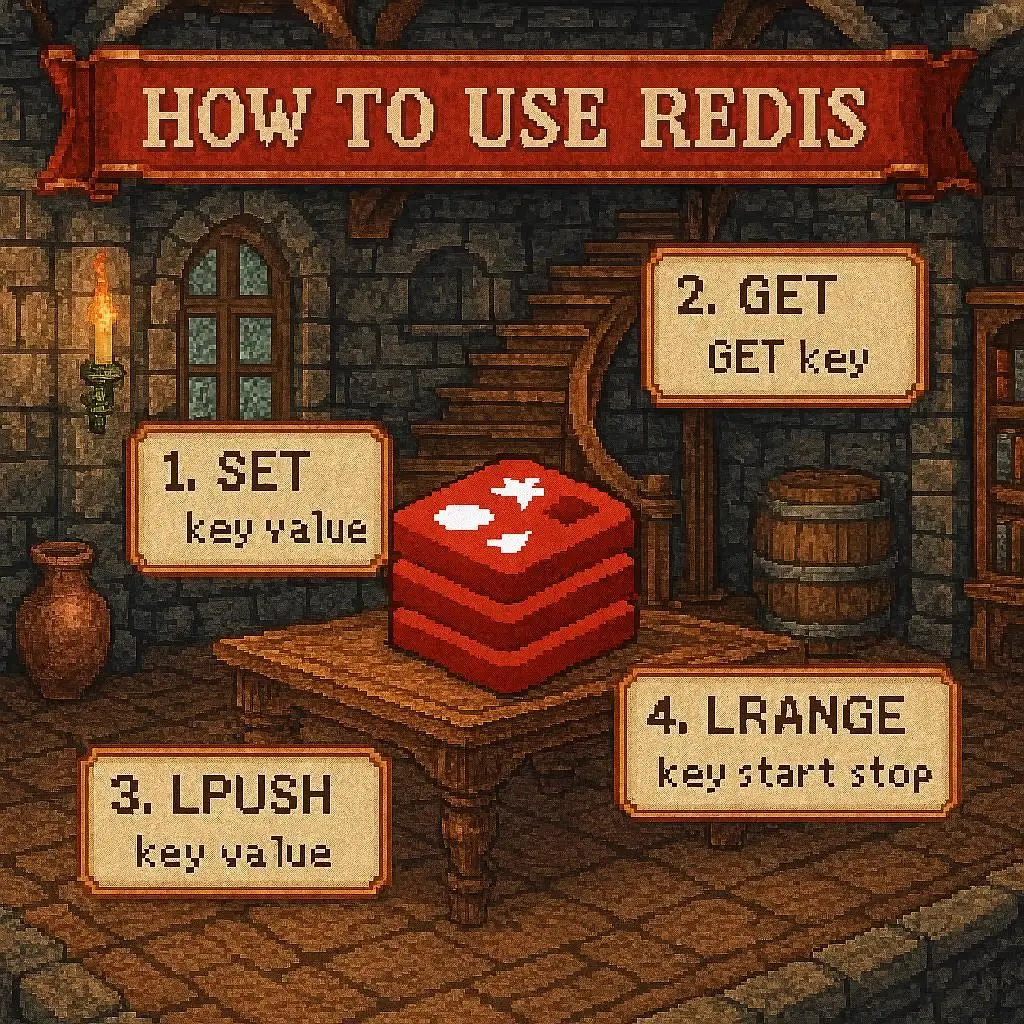

Redisとは、データをディスクではなくメモリ上に置くことで、読み書きの速度を桁違いに引き上げるインメモリ型のデータベースだ。
正式名称はRemote Dictionary Server。
2009年にSalvatore Sanfilippo氏が公開して以来、Twitter・GitHub・Pinterestといった大規模サービスの裏側で使われ続けている。
とはいえ、「メモリに置くだけでなぜそこまで速くなるのか」「MySQLと何が違うのか」と聞かれると、答えに詰まる人は多い。
実際のところ、ディスクへのアクセス速度とメモリへのアクセス速度には数万倍から数十万倍の差がある。
この差が、そのままページ表示の体感速度になって跳ね返ってくる。
結論から言えば、Redisを使うべきかどうかは「速度を最優先し、多少のデータロストを許容できるか」で決まる。
この記事では、Redisが解決する問題の正体から、実務でよく使われる6つの典型パターン、逆に使うと痛い目を見る場面までを整理する。
Redisとは?仕組みと使われる場面を整理
Redisは、一言で表すと「圧倒的な速さを誇るデータの保存場所」です。
主要なWebサービスの多くが、Redisをメインのデータベース(MySQLやPostgreSQLなど)を補助する役割として導入している。
そもそもRedisとは何を解決するデータストアなのか
Redisは、ディスクではなく「メモリ」の上にデータを保存します。
これが最大の特徴であり、速さの秘密です。
一般的なデータベースはデータをハードディスクやSSDに書き込みますが、Redisはメモリ上で読み書きを完結させます。
メモリへのアクセス速度はディスクに比べて数万倍から数十万倍も高速です。
Redisが解決するのは「ディスクI/Oによる遅延」です。
ミリ秒単位、あるいはマイクロ秒単位の超高速な応答が求められる場面で、Redisはその真価を発揮します。
RDB・NoSQLの中での立ち位置
データベースの世界には、大きく分けてRDB(リレーショナルデータベース)とNoSQLがあります。
RedisはNoSQLの一種で、その中でも「KVS(キーバリューストア)」に分類されます。
- RDB (MySQLなど): データの整合性を守り、複雑な条件検索が得意。ただし、大量の同時アクセスや高速な書き込みには限界がある。
- Redis: データの整合性よりも「速度」を最優先。複雑な検索は苦手だが、単純な読み書きは爆速。
RDBが「図書館の書庫」だとすれば、Redisは「作業机の上のメモ帳」です。わざわざ書庫まで探しに行く必要がないため、作業がスムーズに進みます。
メモリ型データベースが選ばれる理由
2026年現在のアプリケーションは、膨大なデータをリアルタイムに処理しなければなりません。
SNSの通知、ゲームのランキング、チャットのメッセージなど、ユーザーは「即座」の反応を求めています。
ディスクベースのデータベースでは、物理的な読み書きの待ち時間が発生し、この要求に応えるのが難しくなってきました。
そこで選ばれるのがメモリ型データベースです。
特にRedisは、単に速いだけでなく、リストやハッシュといった便利なデータ構造を持っているため、開発者にとって扱いやすい。
メモリの大容量化と低価格化も、Redisの普及を後押ししました。
Redisの主な用途は?使うべき典型的な6つのケース
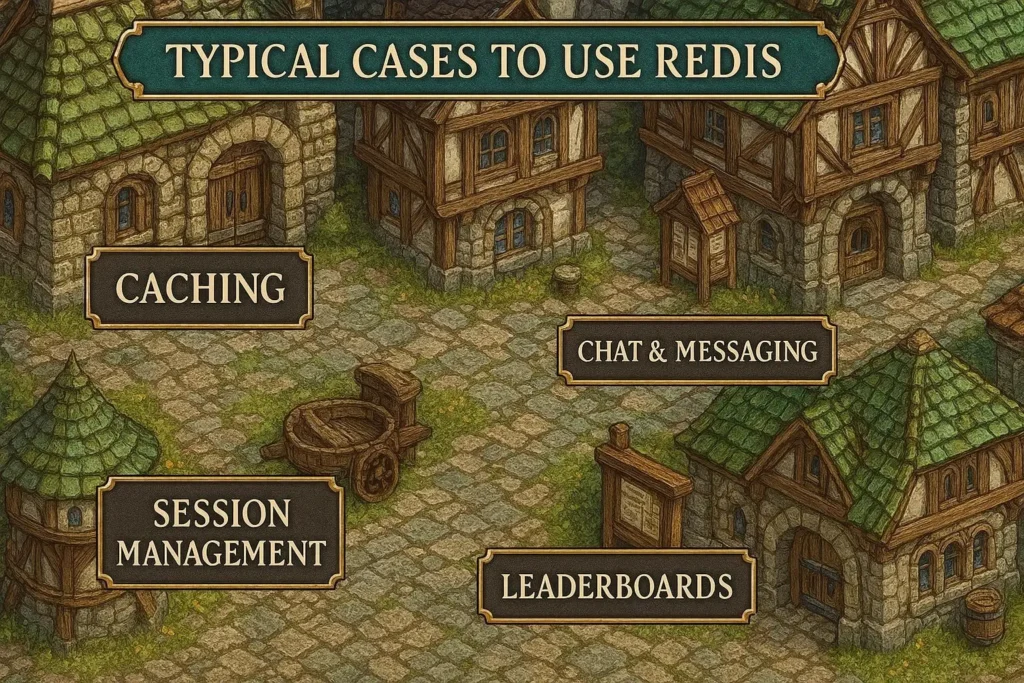
代表的な使いどころは、キャッシュ・セッション管理・ランキング処理・キュー管理・Pub/Sub通知・レートリミットの6つである。
爆速アクセスが必要なキャッシュ(DB負荷軽減)
最も王道の使い方は「キャッシュ」です。
Webアプリケーションでは、同じデータを何度もデータベースから取得する場面が多々あります。
例えば、トップページのお知らせ一覧や、商品の基本情報などです。
これらを毎回RDBに取りに行くと、データベースに無駄な負荷がかかります。
そこで、一度取得したデータをRedisに保存(キャッシュ)しておきます。2回目以降のアクセスでは、Redisからデータを返すようにするのです。
Redisキャッシュの導入により、以下のメリットが生まれます。
- ページの表示速度が劇的に向上する。
- メインのデータベースへのアクセスが減り、システム全体が安定する。
「頻繁に読まれるけれど、頻繁には更新されないデータ」は、Redisキャッシュの最適な候補です。
ログインセッション管理(分散環境で便利)
Webサービスの規模が大きくなると、Webサーバーを複数台に増やして負荷分散をします(ロードバランシング)。
このとき問題になるのが「セッション情報」の扱いです。ユーザーがログインしているという状態を、どのサーバーで管理するかという課題が生まれます。
特定のサーバー内だけにセッションを保存していると、ユーザーが別のサーバーに振り分けられたときに「ログインしていない」と判定されてしまいます。
この課題を解決するために、セッション情報をRedisに集約させます。
すべてのWebサーバーがRedisを見に行く構成にすれば、どのサーバーにアクセスしてもログイン状態を正しく維持できます。
Redisは読み書きが非常に速いため、すべてのリクエストでセッション確認を行っても遅延を感じさせません。
ランキング・カウンター処理(インクリメントが強い)
ゲームのスコアランキングや、記事の閲覧数カウンターなどは、Redisが大得意とする領域です。
RDBでリアルタイムランキングを作ろうとすると、全データを読み込んで並べ替える処理(ORDER BY)が必要になり、データ量が増えると極端に重くなります。
Redisには「Sorted Set(ソート済みセット)」という、データを自動的に順番に並べてくれる機能があります。
Sorted Setを使えば、スコアを更新した瞬間に順位が決定し、特定の順位のユーザーを瞬時に取得できます。
また、閲覧数のようなカウンターも、RedisのINCRコマンドを使えば、アトミック(原子的)に安全かつ高速に数値を増やせます。
秒間数千回のカウントアップも余裕で処理できます。
キュー/ジョブ管理(簡易的なメッセージキュー)
重い処理を非同期で実行させたい場合にもRedisが役立ちます。
例えば、ユーザー登録時のメール送信処理や、動画のエンコード処理などです。これらをWebのレスポンスの中で実行すると、ユーザーを待たせてしまいます。
そこで、「メールを送る」というタスク(ジョブ)をRedisのリストに追加します。
裏側で動いている別のワーカープログラムが、Redisからタスクを取り出して順次実行します。
RedisのList型は、先頭に追加して末尾から取り出すといった操作が高速に行えるため、簡易的なメッセージキューとして非常に優秀です。
Pub/Subを使ったリアルタイム通知
チャットアプリや、リアルタイムの通知機能には「Pub/Sub(パブリッシュ/サブスクライブ)」という仕組みが使われます。
これは、あるチャンネルにメッセージを送ると、そのチャンネルを購読している全員に一斉にメッセージが届く仕組みです。
RedisはこのPub/Sub機能を標準で備えています。
WebSocketサーバーとRedisを組み合わせることで、ユーザー間のリアルタイムなメッセージ交換を簡単に、かつ低遅延で実装できます。
レートリミット(アクセス制御)
APIの利用制限(1分間に100回までなど)を実装する場合もRedisが最適です。
ユーザーIDやIPアドレスをキーにして、アクセス回数をRedisでカウントします。
Redisのキーには「有効期限(TTL)」を設定できます。
「1分後に消えるキー」を作成し、その値をカウントアップしていくことで、時間が経てば自動的にリセットされるカウンターが作れます。
これをRDBでやろうとすると、定期的に古いデータを削除するバッチ処理が必要になりますが、Redisなら自動で消えてくれるため実装が非常にシンプルになります。
Redisを使わない方がいいのはどんな場面?
Redisは万能ではありません。特性を理解せずに使うと痛い目を見ます。以下のようなケースでは、他のデータベースを検討すべきです。
永続性が絶対条件のデータ
Redisはメモリ上で動作するため、サーバーの電源が落ちたり再起動したりすると、基本的にはデータが消えます。
ディスクへの保存機能(RDB/AOF)はありますが、設定によっては「直近数秒間のデータ」を失う可能性があります。
注意
消えては絶対に困るデータ(決済の確定情報、ユーザーの個人情報マスターなど)の唯一の保存場所としてRedisを使うのは避けてください。
これらは必ず、高い堅牢性を持つRDB(MySQLなど)に保存し、Redisはあくまで「消えても再構築できるデータ」や「最悪消えても許容できる一時データ」を扱う場所として使うのが鉄則です。
大容量データを保持するシステム
メモリはディスクに比べて高価です。
テラバイト級のデータをすべてRedisに乗せようとすると、インフラコストが跳ね上がります。
具体的には、過去数年分のログデータや、巨大な画像バイナリデータなどをRedisに入れるのは不適切です。
そういったデータはS3などのオブジェクトストレージや、大容量のHDDを持つデータベースに保存し、Redisには「そのデータへのパス」や「よく使う一部のメタデータ」だけを入れるように設計しましょう。
トランザクション整合性が厳密に必要なケース
銀行の送金処理のように、「Aから引いてBに足す」という処理が、いかなる障害があっても絶対に矛盾なく完了しなければならないケースです。
Redisにもトランザクション機能やLuaスクリプトによる原子性(処理の途中で中断せず、すべて実行されるか全く実行されないかのどちらかになる性質)の保証はありますが、RDBが持つACID特性(特に厳密な耐久性や隔離性)と比較すると簡易的です。
複雑なリレーションや、複数テーブルにまたがる厳密なトランザクションが必要な業務ロジックは、素直にRDBに任せるのが安全です。
Redisの基本的な使い方|インストールと代表的なコマンド
手元で触ってみるのが理解への近道だ。Dockerが使える環境なら、次の1行でRedisサーバーが立ち上がる。
docker run -d -p 6379:6379 redisMacであれば、Homebrewでもインストールできる。
brew install redis
redis-server起動したら、redis-cli コマンドで対話的に操作できる。
redis-cli
127.0.0.1:6379> SET user:1:name "Taro"
OK
127.0.0.1:6379> GET user:1:name
"Taro"
127.0.0.1:6379> INCR page_views
(integer) 1
127.0.0.1:6379> EXPIRE page_views 60
(integer) 1SET/GETで値を出し入れし、前述のINCRでカウンターを増やし、EXPIREで有効期限を設定する。
この4つのコマンドの組み合わせだけでも、キャッシュ・カウンター・レートリミットのプロトタイプは十分に作れる。

Redisを導入する時に考えるべき技術ポイント
Redisを導入する際、エンジニアとして押さえておくべき設定や設計の勘所があります。
Eviction Policy(キャッシュの消し方)の選び方
メモリがいっぱいになったとき、Redisはどのデータを消して新しいデータを入れるのでしょうか。
この挙動を決めるのが「Eviction Policy」です。
- allkeys-lru: すべてのキーの中から、最近最も使われていないものを消す。キャッシュ用途ではこれが一般的。
- volatile-lru: 有効期限が設定されているキーの中から、最近最も使われていないものを消す。消えてほしくない永続データが混在している場合に使う。
- noeviction: 新しい書き込みをエラーにする。絶対に勝手に消してはいけない場合。
用途に合わせてこの設定を正しく選ばないと、「必要なデータが勝手に消えている」あるいは「メモリ溢れでエラーになる」というトラブルを招きます。
Persistence(AOF・RDB)の違い
データの永続化設定には2つの方式があります。
- RDB (Snapshot): 定期的にメモリの状態をまるごとディスクに保存する。復旧は早いが、保存の合間のデータは失われる。
- AOF (Append Only File): 書き込みコマンドをすべてログとして記録する。データロストは最小限にできるが、ファイルサイズが大きくなりやすく、復旧に時間がかかる。
本番環境では、RDBとAOFを組み合わせるか、パフォーマンスを重視して永続化自体をオフにし、キャッシュ専用と割り切って運用するかのいずれかを選ぶのが一般的だ。
クラスタ構成とスケールアウトの考え方
データ量が増えて1台のメモリに収まらなくなった場合、「Redis Cluster」を使ってデータを複数台に分散(シャーディング)させます。
これにより、メモリ容量と書き込み性能を水平方向にスケールアウトできます。
ただし、クラスタ構成にすると、複数のノードにまたがるキーの操作ができなくなるなどの制約が生まれます。
最初から将来の規模を見越して、キーの設計(ハッシュタグの利用など)を考慮しておく必要があります。
可用性の確保(Sentinel / レプリケーション)
Redisサーバーが1台だけだと、そのサーバーが落ちた瞬間にサービス全体が停止する恐れがあります。
サービス全体の停止を防ぐために「レプリケーション(複製)」を使います。マスター(書き込み用)のデータをスレーブ(読み取り用)にコピーしておくのです。
さらに「Redis Sentinel」という監視ツールを使えば、マスターがダウンしたときに、自動的にスレーブを新しいマスターに昇格させてくれます。
AWSのElastiCacheなどのマネージドサービスを使えば、このあたりの冗長構成を自動で管理してくれるため、運用が非常に楽になります。
なお、2024年のRedisライセンス変更を機に、Linux FoundationがRedis 7.2.4をフォークした「Valkey」が登場した。
AWSは新規のElastiCache・MemoryDBクラスタで「特別な理由がない限りValkeyを使う」ことを公式に推奨しており、Redis OSSより料金も低く設定されている。
コマンド体系はRedisとほぼ互換のため、本記事で扱う使いどころ・コマンドの多くはValkeyでもそのまま通用する。
Redisのメリット・デメリットまとめ
ここまで見てきた「使うべき場面」「使わない方がいい場面」を、メリット・デメリットとして一度整理しておく。
- メリット①速度: メモリ上で読み書きするため、ディスクベースのDBと比べて桁違いに高速。
- メリット②多様なデータ構造: List・Set・Hash・Sorted Setなど、用途に応じた構造をそのまま扱える。
- メリット③TTLによる自動削除: 有効期限を設定すれば、レートリミットのようなカウンターも自動でリセットされる。
- メリット④Pub/Sub標準搭載: リアルタイム通知の仕組みを追加のミドルウェアなしで実装できる。
- メリット⑤コア機能の拡張: Redis 8ではJSON型・全文検索・時系列データ・ベクトル検索(AIの埋め込み検索用途)がコアに統合され、単体で扱えるデータの幅が広がっている。
- デメリット①データ消失リスク: メモリ上で動作するため、再起動や障害時に直近のデータを失う可能性がある。
- デメリット②コスト: メモリはディスクより単価が高く、大容量データを乗せるとインフラコストが跳ね上がる。
- デメリット③トランザクションの弱さ: RDBのACID特性ほど厳密ではなく、複雑なリレーションを持つ業務ロジックには不向き。
「速度を最優先し、多少のデータロストは許容できる場面か」がRedisを選ぶかどうかの分かれ目になる。
Redisと他の選択肢の比較
Memcached・Kafka・RDBキャッシュとの違いを比較すると、Redisの立ち位置がより明確になる。
MemcachedとRedisの違い
MemcachedはRedisより古くからある、シンプルなインメモリキャッシュです。
- Memcached: シンプルな文字列しか扱えない。マルチスレッドで動作するため、極端な高負荷時にはCPU効率が良い場合がある。
- Redis: リストやハッシュなど多彩な型が使える。データの永続化やレプリケーション機能がある。
2026年現在、機能の豊富さとエコシステムの充実度から、新規採用ではRedis・Valkeyのいずれかが選ばれることがほとんどです。
Memcachedを選ぶ理由は「既存システムが使っているから」あるいは「極めて限定的な単純キャッシュ用途」に限られます。
Kafkaとの役割の違い(ログストリーム vs メモリ高速処理)
Kafkaも大量のデータを扱いますが、役割が違います。
- Kafka: データの「ログ」をディスクに永続的に保持し、順序通りに流すことが得意。大規模なデータパイプライン向け。
- Redis: 「現在の最新状態」をメモリ上で高速に読み書きすることが得意。
「過去1週間の全アクセスログを分析する」ならKafkaやデータウェアハウス、「今この瞬間のアクセス数を知る」ならRedis、といった使い分けになります。
RDBキャッシュとRedisキャッシュの比較
MySQLなどにもクエリキャッシュ機能はありますが、Redisを外部キャッシュとして使うのとは柔軟性が違います。
DB内部のキャッシュは、テーブルが更新されると関連するキャッシュがすべて破棄されるなど、制御が難しい面があります。
一方、Redisを使えば、アプリケーション側で「このデータは5分間キャッシュする」といった細かい制御が可能です。
アプリのロジックに合わせたきめ細やかな高速化戦略がとれるのがRedisの強みです。

実プロダクトではどう使われているのか?
実際の現場での活用事例を見てみましょう。
ECサイトの在庫・カートの高速化
セールの開始直後、注文が殺到しても在庫数を正確に管理する必要があります。
RDBで在庫を減らす処理を行うと、ロック待ちが発生して処理が詰まってしまいます。
そこで、Redis上で在庫カウンターを管理します。
DECRコマンドでメモリ上の数値を減らし、在庫が確保できたユーザーだけが決済に進むフローにすることで、大量のアクセスをさばききることができます。
SNSのタイムライン・通知の高速化
フォローしているユーザーの投稿を並べて表示するタイムラインは、生成コストが高い処理です。
投稿があるたびに、フォロワーのRedis上のリスト(タイムライン用キー)に投稿IDをプッシュしておきます。
ユーザーが閲覧するときは、Redisからリストを取得するだけで済むため、SQLで複雑な結合をする必要がなく、瞬時にタイムラインを表示できます。
マイクロサービスのセッション共有
大規模なサービスでは、機能ごとにシステムが分かれる「マイクロサービスアーキテクチャ」が採用されます。
認証サービス、商品サービス、決済サービスなどが別々に動く中で、ユーザーのログイン状態を共有するためにRedisが中心的な役割を果たします。
Redisを見れば誰からのアクセスか分かるため、サービス間の連携がスムーズになります。
レートリミットでAPI保護
外部にAPIを公開しているサービスでは、特定のユーザーによる攻撃的なアクセスを防ぐためにRedisを使います。
NginxなどのWebサーバー層や、アプリケーションのミドルウェア層でRedisをチェックし、規定回数を超えたリクエストを即座に遮断します。
これにより、バックエンドシステムを守ることができます。

よくある質問
Q1. Redisとは簡単に言うと何ですか?
A1. Redisとは、データをメモリ上に保存する高速なデータベースです。ディスクを使う一般的なデータベースより数万倍から数十万倍速く読み書きできるため、キャッシュやセッション管理に使われます。
Q2. RedisとMySQLの違いは何ですか?
A2. MySQLはディスクにデータを保存し複雑な条件検索を得意とするRDBです。Redisはメモリ上でデータを扱い、複雑な検索は苦手な代わりに単純な読み書きが非常に高速です。両者は競合ではなく、Redisが補助役として組み合わされるのが一般的です。
Q3. RedisとValkeyはどちらを選べばいいですか?
A3. コマンド体系はほぼ互換のため、新規案件でAWSのElastiCache・MemoryDBを使うならデフォルトのValkeyで問題ありません。既存システムがRedisを使っている場合は、無理に移行する必要はありません。
Q4. Redisはどんなときに使うべきですか?
A4. キャッシュ・ログインセッション管理・ランキング処理・キュー管理・Pub/Sub通知・レートリミットの6つが代表的な使いどころです。共通するのは「速度を最優先し、多少のデータロストを許容できる」場面であることです。
Q5. Redisはどんなときに使うべきではありませんか?
A5. 決済確定情報など消えて困るデータの唯一の保存場所にする、テラバイト級の大容量データを保持する、銀行送金のような厳密なトランザクションが必要、という3つの場面ではRedis単体での運用は避けるべきです。
Q6. Redisのデータは永続化できますか?
A6. RDB(スナップショット)とAOF(コマンドログ)の2方式で永続化できます。ただし設定によっては直近数秒のデータを失う可能性があるため、消えて困るデータは別途RDB(MySQLなど)に保存するのが鉄則です。
まとめ:Redisは“速度が正義”の領域で最強
Redisは、2026年現在のWeb開発において「速度」という最もシビアな要件に応えるための最強の武器です。
Redisが活躍するのは「速さ・同時接続・単純操作」
- ディスクアクセスを待っていられないほどの速さが必要なとき。
- 何万人ものユーザーが同時にアクセスする同時接続をさばくとき。
- キーを指定して値を取るような単純操作を大量に行うとき。
これらが当てはまるなら、Redisは間違いなくあなたの助けになります。逆に、複雑な検索やデータの永続性が最優先なら、RDBを使いましょう。適材適所が重要です。
まずキャッシュ用途から導入するのが安全ルート
もしあなたがRedisの導入を迷っているなら、まずは「データベース負荷軽減のためのキャッシュ」として小さく始めてみることをおすすめします。
既存のデータベースを変更する必要がなく、万が一Redisが止まっても、データベースから直接データを取ればいいだけなので、システム全体が止まるリスクを低く抑えられるからです。
もっとも、「まずキャッシュから」が常に正解とは限らない。ロードバランサーで複数台構成にした瞬間から、セッション共有の問題は発生する。
だとすれば、構成を組んだ初日からセッション管理にRedisを使ってしまう方が合理的な場合もある。
後から「キャッシュ層」と「セッション層」を別々に設計し直す手間が省けるからだ。
どちらから手をつけるべきかは、「今のシステムがすでに複数台構成か」で判断するとよい。
キャッシュ導入の効果はすぐに現れます。
「サイトがサクサク動くようになった!」とユーザーに喜ばれ、インフラコストも下がる未来が待っています。
まずは手元の開発環境で、Redisをインストールしてその爆速ぶりを体感してみてください。きっと、もうディスクアクセスには戻れなくなるはずです。


