
Javaの正規表現は、「数字だけか」「メールアドレスの形になっているか」のような文字列のパターンを判定・検索・置換するための仕組みです。PatternとMatcherの2つのクラスと、Stringのmatches()・replaceAll()などから使えます。
つまずきやすいのは、Javaの文字列リテラルの中ではバックスラッシュを2つ重ねる「二重エスケープ」が必要になる点です。私も学び始めのころは、ここで何度もエラーを出しました。
この記事では、メタ文字の基本から、入力チェック・抽出・置換のコード例、matches()とfind()の違い、性能と安全面の注意点までを順に説明します。
正規表現とは|Javaで使う意味を理解しよう
最初に、Javaで正規表現を扱ううえでの基本的な考え方や、その役割について見ていきましょう。
正規表現の基本的な考え方
正規表現とは、文字列のパターンを表現するための特殊な文字列です。ひと言でいうと「文字列のルールブック」のようなもの。
例えば、「3桁の数字-4桁の数字」という形式の郵便番号を探したい場合、「数字が3つ、次にハイフン、最後に数字が4つ」というパターンを正規表現で表現します。
このパターンを使えば、たくさんの文章の中から郵便番号だけを正確に見つけ出せるのです。
特定のルールに合った文字列を扱うための強力なツールが正規表現です。
Javaで正規表現を使う3つの場面
Javaプログラミングにおいて、正規表現は主に次の3つの場面で活躍します。
- 文字列の検索・抽出大量のテキストデータから、特定のパターンに一致する部分だけを探し出す場面です。例えば、WebページのHTMLソースからURLだけをすべて抜き出したり、ログファイルからエラーメッセージだけを抽出したりする際に使われます。
- 文字列の置換パターンに一致した部分を、別の文字列に置き換える処理です。個人情報保護のために、文章中の電話番号をすべて「***」のような伏字に置き換える、といった用途で活用できます。
- バリデーション(妥当性検証)ユーザーが入力したデータが、決められた形式に沿っているかチェックする場面で役立ちます。メールアドレスや電話番号、パスワードの強度など、特定のフォーマットを守らせたい場合に必須の技術です。
PatternとMatcherクラスの関係
Javaで正規表現を扱う際には、主にjava.util.regexパッケージに含まれるPatternクラスとMatcherクラスを利用します。
Patternクラス: 作成した正規表現のパターンを、コンピュータが理解できる形式にコンパイル(変換・準備)するためのクラスです。料理でいう「レシピ」に相当します。Matcherクラス: コンパイルされたPatternを使い、実際に特定の文字列に対してマッチング処理(照合)を行うためのクラスです。「レシピ」をもとに調理を行う「シェフ」と考えると分かりやすいでしょう。
まずPatternクラスで文字列のルールを定義し、次にMatcherクラスでそのルールを対象の文字列に適用する、という流れが基本です。
Javaの正規表現の基本構文をマスターしよう
正規表現を使いこなすには、その根幹となる「メタ文字」と基本構文の理解が欠かせません。
メタ文字(.・*・+など)の意味
正規表現では、特別な意味を持つ文字を「メタ文字」と呼びます。これらを組み合わせることで、複雑な文字列のパターンを表現します。
代表的なメタ文字をいくつか紹介します。
これらはほんの一部ですが、これだけでも多くのパターンを表現可能です。
よく使う正規表現パターン一覧
実務で頻繁に使われるJava正規表現のパターンをいくつか見てみましょう。
これらのパターンはコピーしてすぐに使えますし、自分でカスタマイズする際の土台にもなります。
初心者が混乱しやすいエスケープのルール
Javaの正規表現で初心者が最もつまずきやすいのがエスケープ処理です。
正規表現のメタ文字(. や * など)を、特別な意味ではなく「ただの文字」として扱いたい場合は、直前にバックスラッシュ\を置きます。
例えば、IPアドレスの区切りである.を探したい場合は、\.と記述します。
ここからがJava特有のルールです。
Javaの文字列リテラル内では、バックスラッシュ\自体も特殊文字として扱われるため、\を記述するには\\と2つ重ねる必要があります。
結果として、正規表現で\dと書きたいパターンは、Javaのコード内では"\\d"と書かなければなりません。
この「二重のエスケープ」が、多くの混乱を招く原因です。
- 正規表現の世界:
\d(数字) - Javaコードの世界:
"\\d"
このルールを最初にしっかり押さえておきましょう。
Javaでの正規表現の書き方と実装例
それでは、実際にJavaのコードで正規表現を使う方法を、サンプルコードを交えながら解説します。
compile()とmatcher()の基本構文
Javaで正規表現を利用する際の基本的なコードの流れは、以下の3ステップです。
Pattern.compile()メソッドで、正規表現パターンをコンパイルします。- 生成した
Patternオブジェクトのmatcher()メソッドに、検査したい文字列を渡してMatcherオブジェクトを取得します。 Matcherオブジェクトのメソッドを使い、マッチング結果を処理します。
文字列を検索・抽出するサンプルコード
文章中から、パターンに一致する部分をすべて検索して抽出する例を見てみましょう。whileループとfind()メソッドを組み合わせるのが定石です。
このコードを実行すると、090-1111-2222と080-3333-4444がそれぞれ出力されます。

マッチ結果の扱い方(find・group)
Matcherクラスには、マッチ結果を柔軟に扱うための便利なメソッドが用意されています。
- find():対象文字列内に、パターンと一致する部分があるかどうかを検索します。見つかればtrueを返し、内部的にどの部分にマッチしたかを記録します。whileループで使うと、次の一致箇所へと検索を進めてくれます。
- group():find()などで見つかった、直近のマッチ部分全体を文字列として返します。group(0)も同じ結果を返します。
- group(int index):正規表現パターン内で()を使ってグループ化した部分を、インデックスで指定して取り出します。グループは左の(から順に1, 2, 3...と番号が振られます。
このようにグループ化を使うと、マッチした文字列をさらに分解して扱えるため、データ抽出の幅が広がります。
replaceAll()とsplit()メソッド
PatternとMatcherクラスを使わずに、Stringクラスのメソッドで直接正規表現を使うこともできます。
簡単な置換や分割であれば、こちらの方がコードがシンプルになります。
replaceAll()で一括置換
replaceAll()は、正規表現にマッチしたすべての箇所を置換します。
replaceFirst()を使えば、最初にマッチした箇所だけを置換できます。
split()で文字列分割
split()は、正規表現にマッチした箇所で文字列を分割し、配列として返します。
カンマ区切りのデータや、複数の区切り文字を一度に処理する場合に便利です。
注意点として、replace()メソッドは正規表現を使わず、純粋な文字列の置換を行う点がreplaceAll()との違いです。
正規表現が不要な場合はreplace()を使いましょう。
実践で使える!正規表現の応用例
ここからは、より実務に近い応用例を3つ紹介します。
メールアドレスの形式チェック
ユーザー登録フォームなどで必須となるメールアドレスのバリデーションです。
matches()メソッドは、文字列全体がパターンに完全一致するかどうかを判定するため、形式チェックに適しています。
電話番号・郵便番号のチェック
ハイフンの有無を許容するなど、少し柔軟なパターンを組む例です。?メタ文字を使えば「直前の文字が0回または1回出現する」ことを表現できます。
※単純な?だけでは不十分な場合、|(または)を使って複数のパターンを組み合わせることも有効です。
数値かどうかをチェックする方法
入力された文字列が数値かどうかを判定したい場面はよくあります。整数のみであれば^[0-9]+$というシンプルなパターンで判定できます。
小数やマイナスの符号も許容したい場合は、^-?\d+(\.\d+)?$のように小数点以下をオプション(?)で扱うパターンを使います。
全角・半角チェックの実装例
フォーム入力のバリデーションでは、「全角文字だけを許容する」「半角英数字だけを許容する」といったチェックもよく必要になります。
Unicodeの範囲を指定することで判定できます。
ログやHTMLから特定データを抽出する
大量のテキストから必要な情報だけを抜き出す、正規表現の真骨頂ともいえる使い方です。
例えば、ApacheのアクセスログからIPアドレスとステータスコードを抽出する例を考えます。
ただし、HTMLの解析はタグのネスト構造などが複雑なため、専用のパーサーライブラリ(Jsoupなど)を使う方が堅牢です。
正規表現はあくまで簡易的な抽出手段と考えるのが良いでしょう。
Javaの正規表現でよくあるエラーと対処法
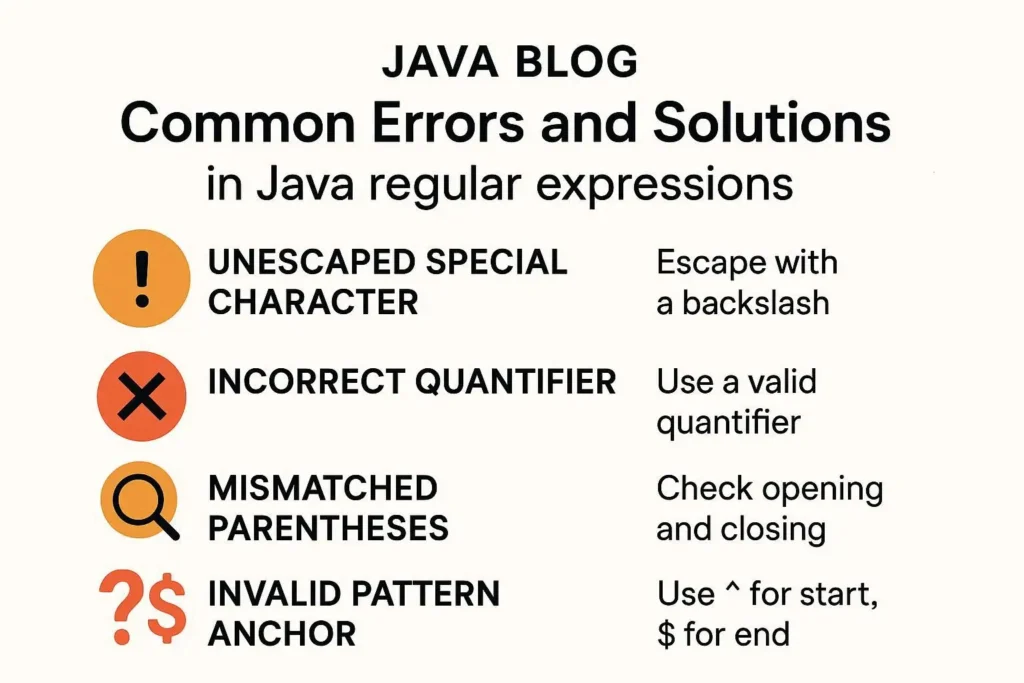
開発中に遭遇しやすいエラーとその対処法を知っておくことで、デバッグの時間を大幅に短縮できます。
エスケープ漏れによる構文エラー
PatternSyntaxExceptionは、正規表現の構文自体に誤りがある場合に発生する最も代表的な例外です。
原因の多くは、メタ文字( (, [ , * , + など)をただの文字として使いたいのに、エスケープ( \\ を前につける)を忘れていることです。
エラーメッセージに「Unclosed group」や「Dangling meta character」といったヒントが表示されるので、メッセージが指し示す箇所の構文を見直しましょう。

また、ユーザー入力などの外部データを正規表現パターンに含める場合は、Pattern.quote()メソッドでエスケープしましょう。
これにより、メタ文字が含まれていても安全に処理できます。
マッチしない原因をデバッグする方法
パターンが期待通りにマッチしない場合、以下の方法で原因を切り分けるのが効果的です。
- オンラインテスターを使う:Web上には多くの正規表現テストツールが存在します。Javaのコードに組み込む前に、まずはテスターサイトでパターンと対象文字列を試し、意図通りにマッチするか確認しましょう。これにより、問題がパターン自体にあるのか、Javaのコード実装にあるのかを切り分けられます。
- パターンを単純化する:複雑な正規表現がマッチしない場合、一度パターンを単純なものに分解して、どこまでが正しくマッチするかを部分的にテストします。少しずつ要素を付け足していくことで、問題の原因となっている箇所を特定しやすくなります。
- matches()とfind()を使い分けているか確認する:matches()は文字列全体がパターンに一致しないとfalseになります。一方、find()は文字列の一部でも一致すればtrueを返します。この違いを理解せず、意図しないメソッドを使っていないか確認しましょう。
パフォーマンスが低下する原因と改善策
正規表現は強力ですが、書き方によっては著しくパフォーマンスが低下することがあります。
- Patternオブジェクトの再利用:Pattern.compile()は、内部的にコストの高い処理を行っています。ループ処理の中で毎回compile()を呼び出すのは避け、ループの前に一度だけコンパイルし、生成したPatternオブジェクトを使い回すようにしましょう。
- 破滅的なバックトラックを避ける:入れ子になった量指定子(*や+)を含む複雑な正規表現は、「破滅的なバックトラック」と呼ばれる現象を引き起こし、入力が長くなるほど処理時間が急激に増えることがあります。(a+)+b のような典型例はJDK 21・23では最適化されて遅くなりませんが、(.*a){12} のように量指定子を含む部分を繰り返すパターンでは、OpenJDK 23.0.1で「a」を20文字、24文字、26文字並べた入力に対して30ms、126ms、366msと急増しました。できるだけシンプルなパターンを心がけることが重要です。
よくある質問
Q1. Javaで正規表現をチェックに使うにはどうすればいいですか?
A1. matches()メソッドを使います。文字列全体がパターンに一致するかを判定できるため、メールアドレスや電話番号などの形式チェック(バリデーション)に適しています。
Q2. matches()とfind()の違いは何ですか?
A2. matches()は文字列全体がパターンに完全一致するかを判定します。一方find()は文字列の一部でも一致すればtrueを返します。形式チェックにはmatches()、部分抽出にはfind()を使い分けます。
Q3. Javaで正規表現をエスケープするにはどう書けばいいですか?
A3. メタ文字をただの文字として使いたい場合はバックスラッシュを前に置きます。ただしJavaの文字列リテラル内ではバックスラッシュ自体も特殊文字のため、\\dのように2つ重ねる「二重エスケープ」が必要です。
Q4. PatternとMatcherクラスの違いは何ですか?
A4. Patternクラスは正規表現パターンをコンパイルするためのクラスです。Matcherクラスは、コンパイルされたPatternを実際の文字列に適用してマッチング処理を行うクラスです。
Q5. 正規表現のパフォーマンスを改善するにはどうすればいいですか?
A5. Pattern.compile()をループの外で1回だけ実行し、生成したPatternオブジェクトを再利用します。また、入れ子の量指定子は「破滅的なバックトラック」を招くことがあるため避けます。
Q6. 正規表現でよく発生するエラーは何ですか?
A6. PatternSyntaxExceptionが代表的で、メタ文字のエスケープ漏れが主な原因です。外部からの入力をパターンに含める場合はPattern.quote()で安全にエスケープできます。
まとめ:Javaの正規表現を使いこなすコツ
テストツールを活用しながら試す
正規表現の学習において、最も効果的なのは「試行錯誤」です。
オンラインの正規表現テスターや、お使いのIDE(統合開発環境)のプラグインなどを活用し、リアルタイムで結果を確認しながら様々なパターンを試してみましょう。
小さな成功体験を積み重ねることが、上達への一番の近道になります。
おすすめのオンラインテスターはregex101.comです。Javaモードを選択でき、マッチ結果やグループの詳細がリアルタイムで確認できます。
また、IntelliJ IDEAには正規表現のテスト機能が組み込まれており、コード内で直接テストできます。
読みやすい正規表現を書くための工夫
正規表現は、一度作ると後から解読するのが困難になることがあります。数か月後の自分や他の開発者のためにも、読みやすさを意識することは大切です。
複雑なパターンには、Pattern.COMMENTSフラグを使ってコメントを記述したり、処理を分割して単純なパターンの組み合わせにしたりする工夫が有効です。
実務で正規表現を使う際の注意点
冒頭で触れた二重エスケープの混乱は、パターンが複雑になるほど深刻になります。正規表現は万能ではありません。
あまりに複雑な正規表現は、可読性やメンテナンス性を大きく損ないます。
時には、Stringクラスが提供するsubstring()やindexOf()といった基本的なメソッドを組み合わせる方法もあります。
そのほうがコードがシンプルで分かりやすくなる場合があります。
また、外部からの入力を正規表現パターンに含める際は、意図しない処理を引き起こす「ReDoS攻撃」などのセキュリティリスクにも注意が必要です。
ツールの特性を理解し、常に最適な手段を選択する視点を持つことが、優れたエンジニアへの一歩となるでしょう。
| REV. | DATE | 内容 |
|---|---|---|
| 2 | 2026-09-04 | 2026年9月時点の情報で全体を見直し |
| 1 | 2025-10-14 | 初版 |


