
Java開発でORM(Object Relational Mapping)を選ぶなら、結論は3パターンに分かれます。
Spring Boot案件なら「Spring Data JPA」、SQLを自分で管理したいなら「MyBatis」、型安全性を重視するなら「jOOQ」が有力候補です。
この記事では、この判断基準の背景にある(1)ORMの仕組みとインピーダンス・ミスマッチ、(2)Hibernate・JPA・Spring Data JPA・MyBatisを含む7つのORマッパーの特徴、(3)プロジェクト規模・チームスキル別の選定基準を解説します。
10年以上Javaエンジニアとして複数の現場でORMを使い分けてきた経験にもとづいています。
「またSQLの修正か……」とテーブル定義変更のたびに疲弊しているなら、ORMはその負担を根本から減らす選択肢になります。
システム開発の現場では、データベースの変更は日常茶飯事です。そのたびに膨大なSQLを書き直し、テストコードも修正する。
そんな毎日に疲弊し、「もっと本質的なロジックの実装に時間を使いたい」と願うエンジニアは少なくありません。
もしこの状態を放置すれば、あなたのプロジェクトは「変更に弱いシステム」になり下がります。
データベースとプログラムが複雑に絡み合い、ちょっとした仕様変更でもシステム全体が動かなくなるリスクを抱えるからです。
これは技術的負債となり、将来のあなたの時間をさらに奪うでしょう。
私はこれまで10年以上、Javaエンジニアとして多くの現場を見てきました。
新人時代はJDBCでSQLを直接書いていましたが、ORMを導入してからは世界が変わりました。
データ操作が驚くほどシンプルになり、変更にも柔軟に対応できるようになったのです。
JavaのORMとは?基礎からわかりやすく解説
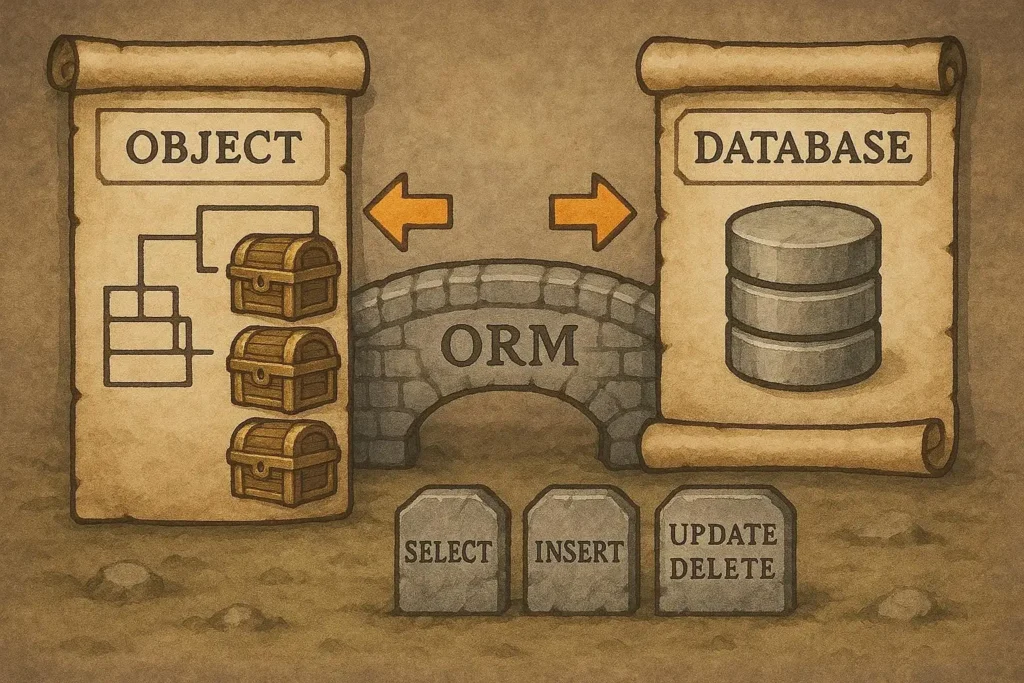
JavaのORMとは、一言で言えば「Javaのオブジェクトとデータベースのテーブルを自動でつなぐ通訳ツール」です。
Javaで扱うデータは「クラスのインスタンス(オブジェクト)」として存在します。一方で、データベースは「テーブルの行」としてデータを管理します。
この二つは形が全く異なるため、そのままではデータのやり取りができません。ORMはこの間に入り、自動的に変換処理を行います。
JavaにおけるORM(Object Relational Mapping)の基本概念
ORMは、オブジェクト指向プログラミングの「オブジェクト」と、リレーショナルデータベースの「関係(リレーション)」をマッピング(対応付け)する技術です。
通常、データベースからデータを取得する場合、SQLを実行して結果セットを受け取り、それをJavaのオブジェクトに詰め替える処理が必要です。
ORMを使うと、この詰め替え作業を自動で行えます。開発者はデータベースの行を意識せず、Javaのクラスを操作する感覚でデータベースを扱えます。
ORMが解決するインピーダンス・ミスマッチ(SQLとオブジェクトのギャップ)
ORMが解決する最大の問題は「インピーダンス・ミスマッチ」です。
これはオブジェクト指向の世界とリレーショナルデータベースの世界の構造がそもそも噛み合っていないという、Javaエンジニアなら一度は聞く専門用語です。
Javaのようなオブジェクト指向言語では、データだけでなく振る舞い(メソッド)や継承関係を持ちます。
しかし、リレーショナルデータベースには継承の概念がなく、データは平坦なテーブル構造で管理されます。
この構造の違いを埋めるために、これまでは開発者が手動で複雑な変換コードを書いていました。
ORMはこの構造的なギャップ(インピーダンス・ミスマッチ)を埋め、Javaのオブジェクト構造をそのままデータベースに保存したり、復元したりできるようにします。
ORMがない場合の開発の面倒さ
もしORMを使わずに開発を進めると、大量のボイラープレートコード(定型コード)が発生します。
JDBCを使って開発する場合を想像してください。まずデータベースへの接続を確立し、SQL文を文字列として作成します。
次にPreparedStatementにパラメータを一つひとつセットします。
そのうえで実行結果をResultSetから取り出し、Javaのオブジェクトのフィールドに手動でセットする必要があります。
テーブルのカラムが一つ増えるだけで、SQL文、パラメータ設定、結果の取得処理のすべてを修正しなければなりません。
これは非常に手間がかかり、人為的なミスも起きやすい作業です。
JavaのORMの代表的な種類(ORマッパー7選)
Javaの世界には優れたORマッパー(ORMフレームワーク)がいくつも存在します。
それぞれに特徴があり、プロジェクトの性質によって使い分けることが大切です。ここでは特によく使われる代表的な4つを紹介します。
Hibernate(Java ORマッパーの定番・高機能)
Hibernateは、Java界隈で最も歴史があり、実績も豊富なORMフレームワークです。
非常に高機能で、オブジェクト指向の概念をデータベースに持ち込むための機能を網羅しています。
キャッシュ機能や遅延読み込み(Lazy Loading)など、パフォーマンスを最適化する仕組みも強力です。
多くのJavaプロジェクトで採用されており、ドキュメントや知見が豊富な点も大きな魅力です。JPAの実装としても広く使われています。
2026年6月時点の最新安定版はHibernate 7.4で、開発版のHibernate 8.0はJakarta Persistence 4.0への対応を進めています。
JPA(Java標準のORマッパー仕様)
JPA(Java Persistence API)は、特定のフレームワークではなく「仕様(ルール)」です。
JavaEE(2018年にEclipse Foundationへ移管されJakarta EEへ改称)の一部として策定されました。
2026年2月には最新版のJakarta EE 12がリリースされています。
インターフェースやアノテーションの書き方を統一する決まりごとであり、実際に動くには「実装」が必要です。
その実装としてHibernateやEclipseLinkなどが使われます。
JPAのルールに従ってコードを書けば、将来的に実装となるフレームワークを入れ替えても、コードの修正を最小限に抑えられます。
標準技術を学びたいなら、まずはJPAの理解が欠かせません。
Spring Data JPA(Spring BootのデファクトORM)
Spring Data JPAは、JPAをベースにしつつ、開発をさらに楽にするための仕組みです。
Spring BootなどのSpringフレームワークと一緒に使われます。
最大の特徴は「インターフェースを定義するだけでSQLが自動生成される」点です。
例えば、findByNameというメソッド名をインターフェースに書くだけで、名前で検索するクエリが自動的に実行されます。
実装クラスを自分で書く必要すらほとんどありません。
2026年時点のJava開発でも、Spring Boot案件(4.0系〜最新の4.1系)ではデファクトスタンダードの地位を保っています。
MyBatis("半ORM"系:SQLも書ける)
MyBatisは、完全なORMではなく「SQLマッパー」と呼ばれることもあります。
HibernateやJPAがSQLを自動生成して隠蔽するのに対し、MyBatisは開発者が自分でSQLを書くスタイルです。
SQLの結果をJavaオブジェクトにマッピングする部分だけを自動化します。
「複雑なSQLを自分で書きたい」「パフォーマンスチューニングのためにSQLを完全に制御したい」という現場で根強い人気があります。
既存のデータベース定義が複雑な場合や、ストアドプロシージャを多用する場合にも適しています。

その他のJava ORマッパー(jOOQ・DOMA・Spring JDBC)
Hibernate・JPA・Spring Data JPA・MyBatisの4大ORマッパー以外にも、用途次第で選択肢になるJava ORMは存在します。
候補として名前を知っておくと、プロジェクト要件と照らしたときの比較軸が広がります。
- jOOQ: 型安全なSQLビルダー。Javaコード上でSELECT文を組み立てることで、コンパイル時にテーブル名やカラム名のミスを検出できる。SQLを書きたいがタイポだけは避けたい、という中間的なニーズに刺さる(2026年6月時点の最新版は3.21系)。
- DOMA: 国内企業で根強く採用される静的SQL型ORM。SQLファイル+DAOアノテーションで構成され、IDE補完の効きが良く、SQLレビュー文化と相性が良い。
- Spring JDBC / JdbcTemplate: 厳密にはORMではなくJDBCの薄いラッパー。トランザクション制御や例外変換はSpringに任せつつ、SQLは手で書きたい小規模プロジェクトに向く。
jOOQ・DOMA・Spring JDBCは4大ORマッパーほどシェアは大きくありませんが、「Hibernate/JPAの抽象度が高すぎる」「MyBatisほど自由にしなくていい」といった中間層の要件にフィットします。
業務要件から逆算して選択肢に含める価値はあります。

JavaでORMを選ぶときの基準
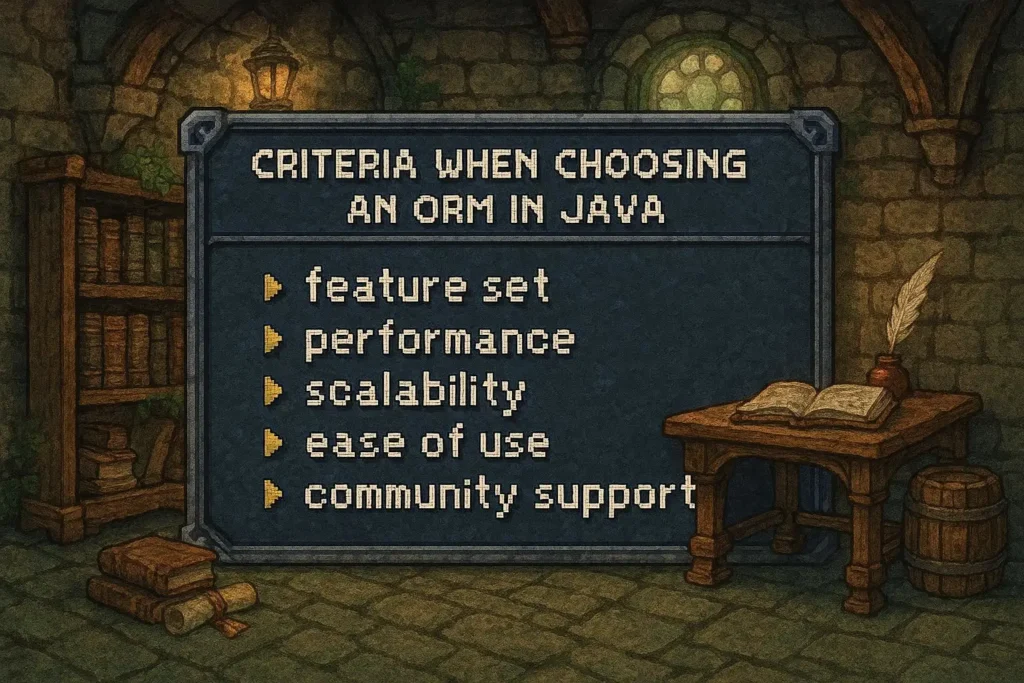
どのORMを選べばいいか迷ったときは、以下の基準で判断してください。プロジェクトの特性に合わせて選ぶのが正解です。
主要4つのJava ORマッパー比較表(Hibernate / JPA / Spring Data JPA / MyBatis)
先に4大ORマッパーの違いを一覧で押さえておきましょう。
迷ったときは、この表を見ながら自分のプロジェクトに当てはまる行をたどれば、おおよその候補が絞れます。
| 項目 | Hibernate | JPA | Spring Data JPA | MyBatis |
|---|---|---|---|---|
| SQL制御度 | 低(自動生成) | 低(仕様) | 最も低(抽象度高) | 高(手書き) |
| 学習コスト | 高 | 中 | 低〜中 | 中 |
| Spring Boot相性 | ○ | ○(実装が必要) | ◎(デファクト) | ○ |
| 自動CRUD生成 | あり | 仕様として定義 | リポジトリを自動実装 | なし(手書き) |
| 向くプロジェクト | 大規模エンタープライズ | フレームワーク非依存の設計 | Spring Boot新規開発 | 複雑SQL・レガシー移行 |
ざっくり言えば、新規のSpring Boot案件ならSpring Data JPA、複雑なSQLや既存のSQL資産が多い現場ならMyBatisが第一候補です。
JPAはあくまで仕様、Hibernateはその最有力実装で、Spring Data JPAの裏側でも動いています。
つまり実戦で「単体選択」になるのはSpring Data JPAかMyBatisの二択、という見立てが現実的です。
SQLを書きたいか?ORマッパー選定の軸
もしチームメンバーがSQLに精通していて、細かいチューニングを自分たちで行いたいなら、MyBatisが適しています。
逆に、SQLの記述を極力減らし、Javaのロジックに集中したい、あるいはSQLがあまり得意ではないメンバーが多いなら、JPAやHibernateが適しています。
プロジェクト規模とパフォーマンスから選ぶORマッパー
大規模で複雑なデータモデルを持つシステムなら、JPAの強力な機能(キャッシュや変更検知)が役立ちます。
一方で、数千万件のデータを扱うバッチ処理や、極限のレスポンス速度が求められるゲームサーバーなどもあります。
こうした場面では、オーバーヘッドの少ないMyBatisや、JDBCに近い薄いラッパーを選ぶ方が安全です。
学習コストとチームスキルから選ぶJava ORマッパー
チームのスキルセットも重要です。
Javaの経験が浅くても、Spring Bootを使った開発経験があるならSpring Data JPAは馴染みやすいです。
しかし、レガシーなシステムからの移行で、既存のSQL資産がたくさんある場合は、SQLをそのまま流用できるMyBatisの方が移行コストを抑えられます。
ライセンスと保守継続性で選ぶ
Hibernate・JPA実装(EclipseLink・OpenJPA)、Spring Data JPA、MyBatis、DOMAはいずれもオープンソースで公開されています。
特定ベンダーにロックインされるライセンス上のリスクは低いといえます。
長期的に保守するプロジェクトでは、機能の豊富さだけでなくGitHub上のコミット頻度・Issue対応の速さといったコミュニティの活発さも選定材料になります。
すでに社内で標準化されたフレームワークがある場合は、新しい技術的な優位性よりもチーム全体の保守のしやすさを優先し、それに合わせる判断も現実的です。
Spring Bootを使うなら選ぶJava ORM
2026年時点でも、新規開発でSpring Bootを採用するなら、Spring Data JPAを選ぶのが最もスムーズです。
設定が自動化されており、依存関係を追加するだけですぐに使えます。
相性が抜群に良く、ドキュメントやサンプルコードも圧倒的に多いため、困ったときに解決策が見つかりやすいのも大きなメリットです。
JavaのORMを使うメリット
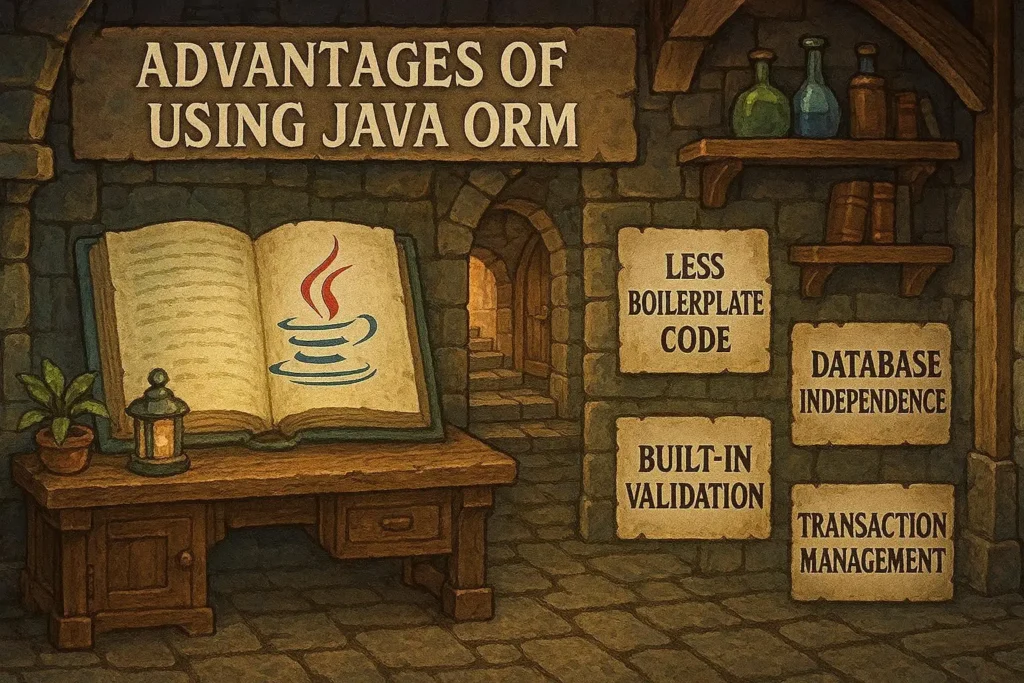
ORMを導入すると、開発プロセス全体に良い影響を与えます。単にコード量が減るだけでなく、システムの品質や保守性を高める効果があります。
SQLを意識せずにオブジェクト操作で開発できる
最大のメリットは、Javaのコードを書くことに集中できる点です。
データの追加はentity.save()、削除はentity.delete()といったメソッド呼び出しで完結します。
複雑なJOIN句を含むSQLを組み立てる必要はありません。ビジネスロジックの記述に専念できるため、開発スピードが格段に上がります。
Javaの文法で完結するため、コンパイル時に型チェックが効くのも大きな利点です。
SQLを文字列で書く場合、実行するまでスペルミスに気づかないことがよくあります。
保守性が高く、モデルの変更に強い
システムの仕様変更に対して強くなります。
データベースのカラム名を変更する場合、SQLを直書きしていると、そのカラムを使っているすべてのSQL文を探し出して修正しなければなりません。
しかしORMを使っていれば、基本的にはエンティティクラスのフィールド名を変更するだけで済みます。
マッピング設定が自動的に追従してくれるため、修正漏れによるバグを防げます。
オブジェクト中心に設計することで、コードの見通しも良くなり、長期的なメンテナンスが楽になります。
DB依存を減らせて移行が楽になる
使用するデータベース製品を変更するハードルが下がります。
データベース製品(MySQL、PostgreSQL、Oracleなど)によって、SQLの方言(独自の書き方)が存在します。
通常、DBを変更するにはSQLの書き直しが必要です。
しかしJPAやHibernateなどのORMは、設定ファイルでデータベースの種類(Dialect)を指定するだけで、そのDBに合わせたSQLを自動生成してくれます。
開発環境は軽量なH2Databaseを使い、本番環境はAWS上のAuroraを使う、といった柔軟な構成も簡単に実現できます。
冗長なCRUD処理が自動化される
この4つの操作、実は書かなくていいとしたらどうでしょうか。
基本的なデータ操作(Create, Read, Update, Delete)のコードを書く必要がなくなります。
ほとんどのアプリケーションで、データの登録や検索といった処理は似通っています。これらの登録・検索処理を毎回手動で実装するのは時間の無駄です。
ORMフレームワークはこれらの標準的な機能を最初から提供しています。
開発者は、そのアプリケーション特有の複雑なビジネスロジックの実装だけに時間を使えるようになります。
JavaのORMのデメリット・注意点
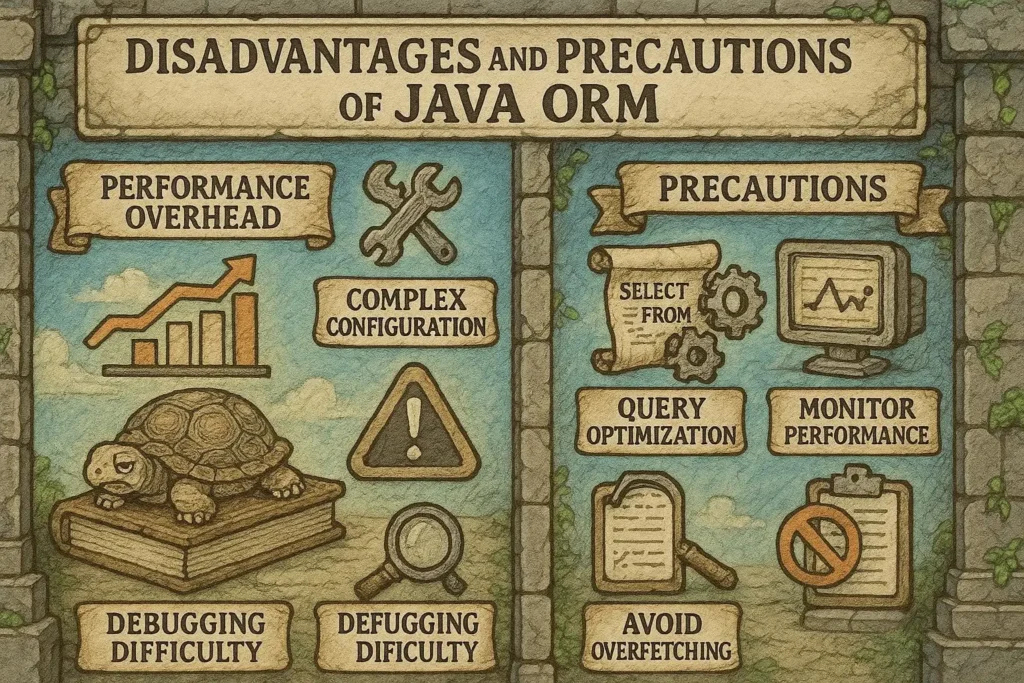
便利なORMですが、銀の弾丸ではありません。仕組みを理解せずに使うと、パフォーマンス問題や予期せぬトラブルを引き起こす可能性があります。
複雑なクエリはパフォーマンスが落ちやすい
自動生成されるSQLは、必ずしも最適なものとは限りません。
特に複数のテーブルが絡む複雑な集計や、大量データを一括更新するような処理では、ORMが生成するSQLよりも、人間が手でチューニングしたSQLの方が高速です。
ORMは汎用的な処理には強いですが、極端に複雑な条件分岐や特殊なデータベース機能を使う処理は苦手です。
そのような箇所だけMyBatisを併用するか、ネイティブクエリ(SQL直書き)を使う判断が必要です。
ORMの仕組みを理解していないと逆にバグを生みやすい
ORMが裏側で何をしているかを知らないと、意図しない挙動に悩まされます。
例えば、エンティティの状態管理(永続化コンテキスト)の仕組みを理解していないと、「データを保存したつもりがないのに、勝手にUPDATE文が発行された」という現象に遭遇します。
これはORMがオブジェクトの変更を検知して自動的にDBと同期をとる機能なのですが、知らないとバグだと誤解しやすくなります。
便利な反面、ツールの挙動を正しく学ぶ姿勢が求められます。
実際に本番環境でつまずいたのが「同一クラス内のメソッド呼び出しでは@Transactionalが効かない」という落とし穴です。
SpringのAOPはプロキシ経由でトランザクション制御を行っています。
そのため、同じクラス内の別メソッドを直接呼び出すとプロキシを経由せず、トランザクションが効かないままDB操作が実行されてしまいます。
この仕様を知らずにコードを書いていたところ、本番でデータ不整合が発生して初めて気づきました。
以降はサービス層を分割し、トランザクション境界をまたぐ処理は別クラスに切り出すことを徹底するようになりました。

Hibernate/JPAの学習コストはどれくらい必要?
使いこなすためには、それなりの学習時間が必要です。
特にJPAやHibernateは機能が豊富で、アノテーションの種類や設定項目が多岐にわたります。
リレーション(1対多、多対多)の設定方法や、フェッチ戦略(データをいつ読み込むか)の概念を理解するには時間がかかります。
簡単なCRUDアプリならすぐに作れますが、トラブルシューティングができるレベルになるには、深い知識が必要です。
N+1問題などORM特有の落とし穴
ORMを使う際にもっとも有名なパフォーマンス問題が「N+1問題」です。
例えば、ユーザー一覧(1回)を取得した後、ループ処理でそれぞれのユーザーに関連する部署情報(N回)を取得してしまう現象です。
本来ならJOINを使って1回のSQLで済むところが、合計でN+1回のSQLが発行されてしまい、システムが極端に重くなります。
これはORMが便利すぎて、裏でSQLが発行されていることを開発者が忘れがちになるために起こります。
ログを確認して発行されるクエリを監視する習慣が必要です。
ORMを採用すべきでないケース
ここまでのデメリットを踏まえると、ORMがすべての場面で最適というわけではないことがわかります。
次のようなケースでは、ORMをそのまま使うより別のアプローチを検討してください。
- 数十万件単位のバッチ更新処理: エンティティを1件ずつ読み込んで更新するORMの仕組みはオーバーヘッドが大きく、大量データの一括更新にはSQLを直接発行するバッチ処理の方が高速です。
- 集計・分析中心のクエリ: GROUP BYや複雑な結合を多用する集計処理は、JPQL/HQLで無理に表現するよりネイティブSQLやjOOQのようなSQLビルダーで直接書いた方が可読性・性能ともに優れます。
- 正規化が崩れた既存スキーマ: レガシーDBでテーブル設計がエンティティモデルと噛み合わない場合、ORMのマッピング定義が複雑化しかえって保守性が下がることがあります。この場合はMyBatisのようにSQLを明示的に書ける選択肢が向いています。

JavaのORMの使い方の流れ(初心者向け)
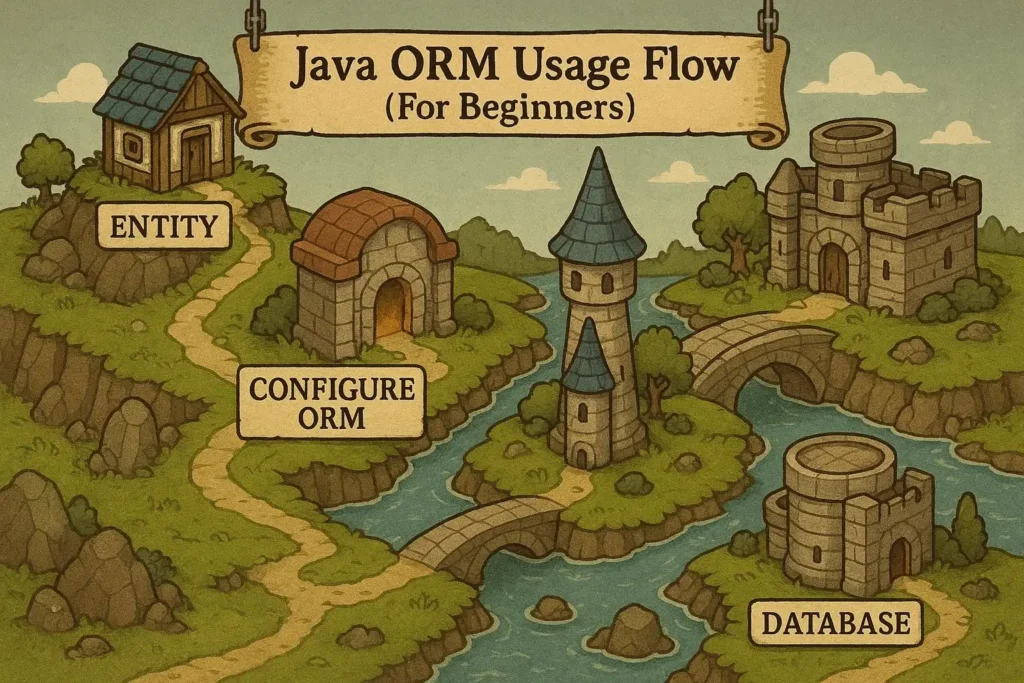
実際にJavaでORMを使うときの基本的な流れを見てみましょう。ここでは2026年時点でも主流のSpring Data JPAを例に説明します。
エンティティクラス(モデル)の作成
step
1エンティティクラス(モデル)の作成
まず、データベースのテーブルに対応するJavaクラスを作ります。これをエンティティと呼びます。
クラス宣言に@Entityというアノテーションを付け、主キーになるフィールドに@Idを付けます。
これだけで、このクラスはデータベースのテーブルと紐づきます。テーブルのカラムとフィールド名は自動的にマッピングされます。
リポジトリの作成(JPA/Spring Dataの場合)
step
2リポジトリの作成
次に、データベースへのアクセスを行うためのインターフェースを作ります。これをリポジトリと呼びます。
JpaRepositoryというインターフェースを継承して作成します。
驚くことに、基本的なCRUDメソッド(save, findAll, deleteなど)は、この継承だけで使えるようになります。
中身の実装コードを書く必要はありません。
CRUD処理を実行してみる
step
3CRUD処理を実行してみる
準備ができたら、実際に使ってみます。
サービス層などのクラスで、先ほど作ったリポジトリを呼び出します。
「データを保存したい」なら、エンティティのインスタンスを作ってrepository.save(entity)と書くだけです。
「全件取得したい」ならrepository.findAll()です。直感的でわかりやすいコードになります。
実際のSQLはどう変換されているのか確認する方法
step
4発行されるSQLを確認する
開発中は、ORMがどんなSQLを発行しているか確認することが大切です。
設定ファイル(application.propertiesなど)でログ出力を有効にすると、コンソールに実行されたSQLが表示されます。
意図しないSQLが流れていないか、無駄なクエリがないかをここでチェックします。この確認作業が、パフォーマンス問題を未然に防ぐ鍵になります。
JavaのORMを使った実例(サンプル)
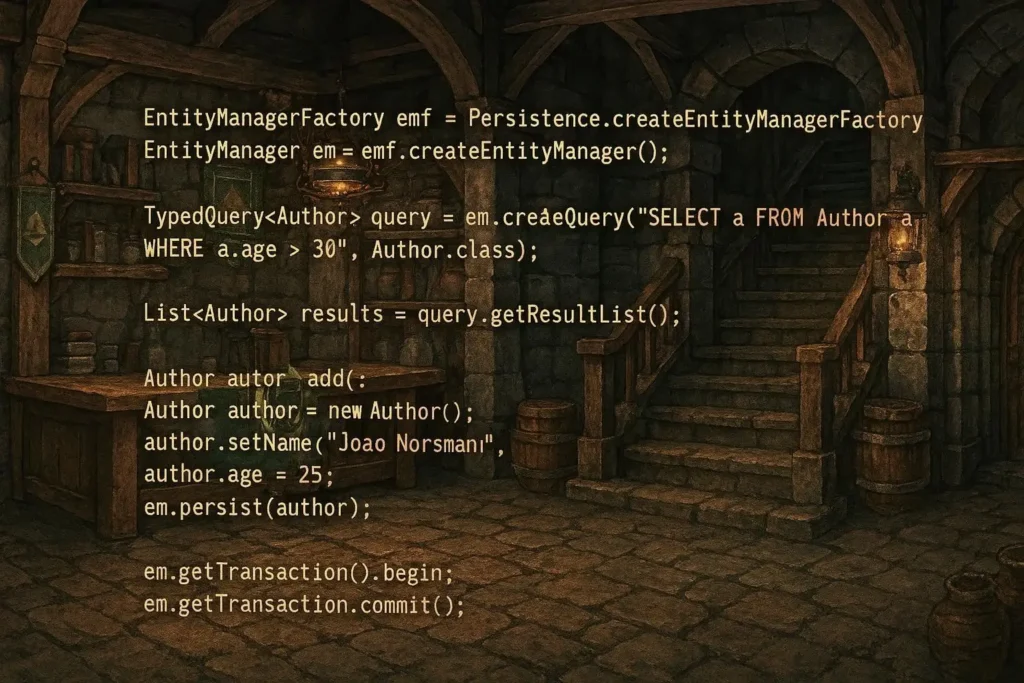
ここでは具体的なコードのイメージを紹介します。シンプルさを伝えるため、最低限の記述に絞っています。
JPAでエンティティを保存する基本コード
まずはテーブル定義代わりになるエンティティクラスです。
import jakarta.persistence.Entity;
import jakarta.persistence.Id;

@Entity
public class User {
    @Id
    private Long id;
    private String name;

    // ゲッターやセッターは省略
}
Spring Data JPAでRepositoryを使う例
次にデータの保存や検索を行うリポジトリです。インターフェースだけで済みます。
import org.springframework.data.jpa.repository.JpaRepository;

public interface UserRepository extends JpaRepository<User, Long> {
    // 名前で検索するメソッドを定義(実装は自動生成される)
    User findByName(String name);
}
MyBatisでSQLを明示的に書く例
SQLを自分で書きたいMyBatisの場合は以下のようになります。
<select id="selectUser" resultType="com.example.User">
  SELECT * FROM users WHERE id = #{id}
</select>
Java側ではメソッドとSQLIDを紐づけます。SQLが見えるので安心感があります。
JavaのORMに関するよくある質問
JavaのORMとJPAの違いは?
ORMは「概念や技術の総称」で、JPAは「JavaにおけるORMの標準仕様(ルール)」です。
自動車で例えるなら、ORMは「車」、JPAは「軽自動車の規格」、Hibernateは「実際に走るN-BOXやタント」のようなイメージです。
MyBatisはJavaのORMに含まれるの?
厳密には「SQLマッパー」に分類されますが、広義のORMとして扱われます。
オブジェクトとDBをつなぐ役割は同じですが、アプローチが異なります。
Java界隈では「JPA派」と「MyBatis派」でよく議論になりますが、適材適所で使い分けるのがプロの選択です。
Java ORMのパフォーマンス問題はどう対策すべき?
まずは発行されるSQLログを見て、N+1問題が起きていないか確認します。
問題があればJOIN FETCHなどを使ってデータを一度に取得するようにクエリを修正します。
また、読み込み専用の処理には@Transactional(readOnly = true)を付けるなど、フレームワークの機能を正しく使うことで改善できます。
Spring Data JPAとMyBatis、どちらを選ぶべき?
新規のSpring Boot案件ならSpring Data JPA、複雑なSQLや既存のSQL資産が多い現場ならMyBatisが基本方針です。SQLを自分で細かく制御したいチームはMyBatis、Javaのロジックに集中したいチームはSpring Data JPAが向いています。
jOOQとDOMAの違いは?
jOOQはJavaコード上でSQLを型安全に組み立てるSQLビルダーで、コンパイル時にタイポを検出できます。DOMAはSQLファイルとDAOアノテーションで構成する静的SQL型ORMで、IDE補完の効きの良さとSQLレビュー文化との相性が特徴です。
ORMを使うとSQLの知識は不要になる?
いいえ、不要にはなりません。ORMは定型的なCRUD処理を自動化しますが、N+1問題の回避や複雑なクエリのチューニングにはSQLの理解が必須です。ORMの裏側でどんなSQLが発行されているかを知ることが、トラブルを防ぐ近道になります。
Java ORMのN+1問題はどう見つければいい?
設定ファイル(application.propertiesなど)でSQLログ出力を有効にし、実際に発行されているクエリの件数を確認します。1回のリクエストで想定外に多くのSELECT文が発行されていれば、N+1問題が起きている合図です。
まとめ:JavaのORMは選び方次第で強力な武器になる
JavaのORMについて、仕組みから選び方まで解説してきました。
ORMは単なる手抜きツールではありません。ビジネスロジックとデータアクセスをきれいに分離し、変更に強く、保守しやすいシステムを作るための土台です。
SQLの泥沼から抜け出し、より価値のある機能開発に集中できるようになります。
結論として、これからJavaで開発を始めるなら、まずはSpring Data JPAを使ってみるのがおすすめです。
理由は2つあります。現代のJava開発(特にSpring Boot)における標準的な選択肢であり、学習リソースも豊富なためです。
そして何より、面倒なコードを書かずに動くアプリケーションが作れる楽しさを実感できるからです。
もしあなたが「SQLを書くのが辛い」と感じているなら、今すぐ小さなプロジェクトでSpring Data JPAを試してみてください。
たった一つのエンティティを作ってデータを保存できた瞬間、その便利さに感動するはずです。


